ENISA Threat Landscape 2026: Cyberrisiken steigen
Ransomware, DDoS und digitale Abhängigkeiten erhöhen die Cyberrisiken für Unternehmen.
Yandex-Rechenzentren nach Drohnenangriffen: Was die Ausfälle für Resilienz, Redundanz und IT-Betrieb bedeuten.

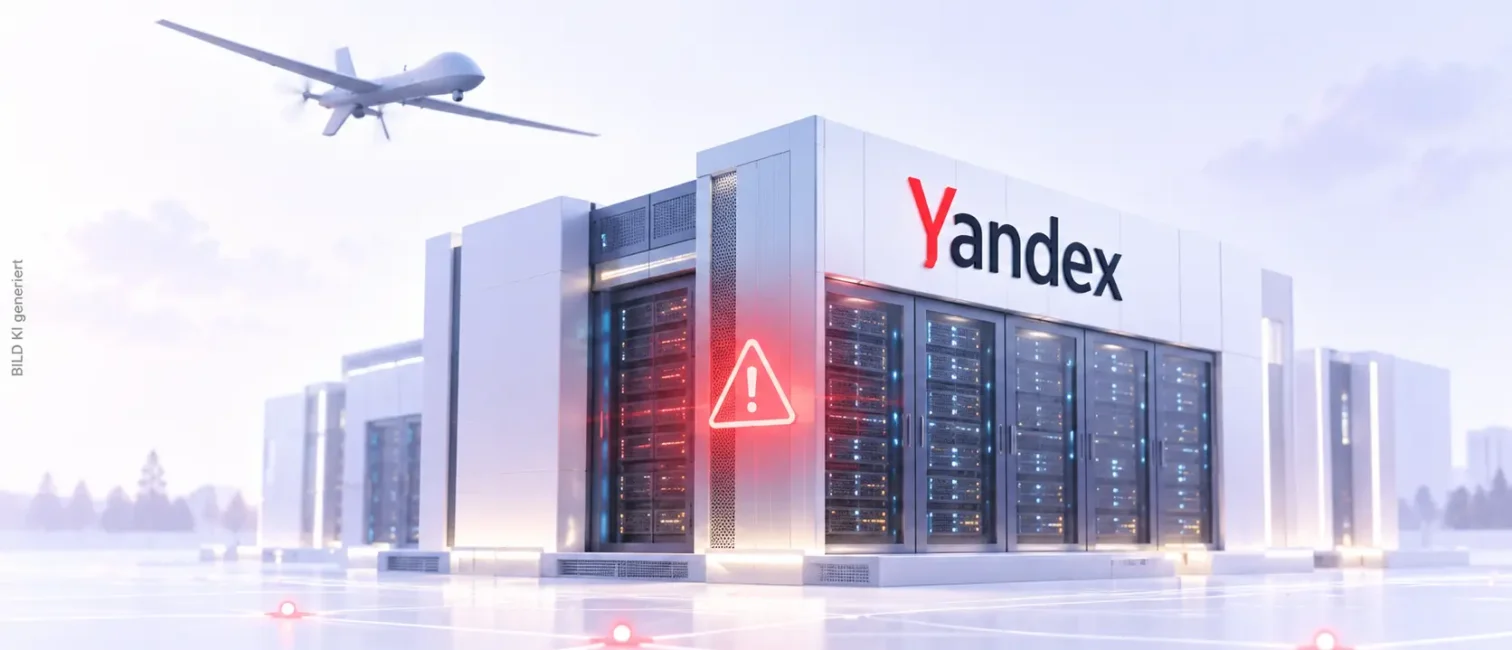
Mehrere Yandex-Rechenzentren in Russland sind nach ukrainischen Drohnenangriffen ausgefallen oder beschädigt worden. Die Angriffe zeigen, dass physische Resilienz und geografische Redundanz für kritische IT-Infrastruktur weiter an Bedeutung gewinnen.
Nach Berichten von Ars Technica wurden am 8. und 9. Oktober zunächst Yandex-Standorte in Sasowo und Kaluga getroffen. Yandex bestätigte Störungen einzelner Dienste, meldete jedoch keine verletzten Mitarbeiter. Einer der betroffenen Standorte soll Supercomputer beherbergen, die für das Training von YandexGPT eingesetzt werden.
Am 11. Oktober folgte ein weiterer Angriff auf ein Yandex-Rechenzentrum in der Region Wladimir. Nach Angaben des Unternehmens wurde die Infrastruktur beschädigt und der Betrieb des Standorts vollständig gestoppt. Wie lange die Reparaturen dauern werden, war zunächst offen.
Damit rückt eine Frage stärker in den Vordergrund, die auch außerhalb des aktuellen Konflikts relevant ist: Wie widerstandsfähig ist digitale Infrastruktur, wenn nicht nur Software und Netzwerke, sondern die physischen Standorte selbst ausfallen?
Die ersten gemeldeten Angriffe richteten sich gegen Yandex-Standorte in Sasowo und Kaluga. Ars Technica berichtet unter Berufung auf Reuters, dass zwei von fünf Yandex-Rechenzentren betroffen gewesen seien. Der Standort in Sasowo soll zwei von drei Supercomputern beherbergen, die Yandex für das Training seines KI-Modells YandexGPT nutzt.
Ein weiterer Angriff traf am 11. Oktober ein Rechenzentrum in Wladimir. Euronews berichtet, dass Yandex dort Schäden an der Infrastruktur bestätigte und den Betrieb vollständig einstellte. Vorläufige Berichte sprechen zudem von Schäden an einem Supercomputer. Dieser Punkt ist bislang jedoch nicht abschließend bestätigt.
Auch der Standort Sasowo wurde nach dem Angriff vom Netz genommen. Yandex warnte dort vor möglichen zeitweisen Störungen einzelner Dienste.
Nach den Angriffen kam es zu Störungen verschiedener Yandex-Dienste. Euronews berichtet unter anderem über Probleme bei Taxi- und Navigationsdiensten in mehreren russischen Städten sowie in weiteren Ländern. Auch andere Online-Dienste sollen zeitweise beeinträchtigt gewesen sein.
Wie groß der langfristige technische Schaden ist, bleibt offen. Das gilt insbesondere für KI-Infrastruktur. Ars Technica berichtet, dass ein betroffener Standort Hardware für das Training von YandexGPT beherbergt. Daraus lässt sich jedoch nicht ableiten, dass das KI-Angebot dauerhaft beeinträchtigt ist.
Für Unternehmen ist diese Unterscheidung wichtig. Ein sichtbarer Dienstausfall sagt noch wenig darüber aus, welche Komponenten dauerhaft beschädigt wurden und wie schnell Kapazitäten an anderen Standorten übernommen werden können.
Rechenzentren bündeln zentrale digitale Ressourcen auf vergleichsweise wenigen physischen Standorten. Dazu gehören Compute-Kapazität, Netzwerkanbindungen, Storage, Stromversorgung und teilweise auch spezialisierte KI-Hardware.
Gerade diese Konzentration macht sie zu kritischen Punkten moderner Infrastruktur. Der aktuelle Konflikt zeigt, dass Rechenzentren nicht nur durch Cyberangriffe, Stromausfälle oder technische Defekte gefährdet sind. Auch direkte physische Schäden können Dienste, Kommunikationsnetze und angeschlossene Plattformen beeinträchtigen.
Das gilt nicht nur für Russland. Ars Technica berichtete bereits Anfang Oktober über russische Angriffe auf ukrainische Rechenzentren und Kommunikationsinfrastruktur. Dabei kam es zu Störungen bei Internet- und Mobilfunkdiensten.
Damit verschiebt sich die Resilienzfrage. Klassische Hochverfügbarkeit innerhalb eines einzelnen Standorts reicht nicht aus, wenn der gesamte Standort ausfällt.
Für IT-Verantwortliche lässt sich aus den aktuellen Ereignissen keine direkte Blaupause ableiten. Die Risikolage eines deutschen Mittelständlers unterscheidet sich deutlich von der eines Rechenzentrums in einem Kriegsgebiet. Die grundsätzlichen Architekturfragen bleiben jedoch vergleichbar.
Entscheidend ist zunächst die Verteilung kritischer Workloads. Wer zentrale Systeme nur an einem Standort betreibt, trägt ein höheres Konzentrationsrisiko. Hybrid-Cloud-Architekturen können einen zweiten Betriebsstandort oder eine externe Wiederanlaufumgebung bereitstellen, sofern Daten, Anwendungen und Identitäten tatsächlich unabhängig wiederhergestellt werden können.
Auch Multi-Cloud-Strategien können Redundanz über Regionen und Anbieter hinweg erhöhen. Sie schaffen jedoch zusätzliche Komplexität und ersetzen keine saubere Disaster-Recovery-Planung.
Hinzu kommt die Standortfrage selbst. IT-Dock berichtete bereits im August, dass Unternehmen ihre Workloads zunehmend auf eigene Rechenzentren, Colocation, Hosting, Cloud und SaaS verteilen. Damit wird die Auswahl des Betriebsmodells stärker von Verfügbarkeit, Regulierung, Kosten und Resilienz abhängig.
Für kritische Anwendungen sollten Unternehmen deshalb nicht nur fragen, ob Backups vorhanden sind. Relevant ist auch, ob sie bei einem vollständigen Standortausfall tatsächlich nutzbar bleiben.
Die Angriffe auf Yandex zeigen, wie eng digitale und physische Infrastruktur miteinander verbunden sind. Selbst stark virtualisierte Umgebungen hängen am Ende von realen Standorten, Stromversorgung, Netzwerken und Hardware.
Für Unternehmen bedeutet das nicht, militärische Szenarien zur Grundlage ihrer Planung zu machen. Sinnvoll ist vielmehr, bestehende Annahmen über Verfügbarkeit regelmäßig zu überprüfen. Dazu gehören geografisch getrennte Wiederanlaufumgebungen, getestete Restore-Prozesse, unabhängige Netzwerkpfade und klare Prioritäten für kritische Anwendungen.
Je stärker Unternehmen Workloads auf externe Infrastruktur verlagern, desto wichtiger wird außerdem die Frage, wo diese Ressourcen tatsächlich betrieben werden. Der Standort von Rechenzentren ist damit nicht nur ein Thema für Compliance und Datenhoheit, sondern auch für Resilienz. Deutsche Unternehmen bewerten den Standort ihrer Cloud-Infrastruktur bereits als wichtiges Auswahlkriterium.
Die aktuellen Ausfälle bei Yandex verdeutlichen deshalb vor allem eines: Hochverfügbarkeit endet nicht am Rack. Sie muss auch Standort, Energieversorgung, Netzanbindung und Wiederanlauf berücksichtigen.
Quellen: Ars Technica, Euronews
Weitere Entwicklungen zu Rechenzentren, Cloud und Infrastruktur ordnet der IT-Dock-Newsletter regelmäßig ein.
Kommentare (0)
Noch keine Kommentare vorhanden.