Nvidia Spionageverdacht: Untersuchung gegen Jensen Huang
Nvidia Spionageverdacht: Der Konzern untersucht Berichte über Jensen Huang. Was bestätigt ist und welche Folgen drohen.
Ein Fehler der Notstromsteuerung führte zu Störungen. Der Incident Report erklärt die Ursache.

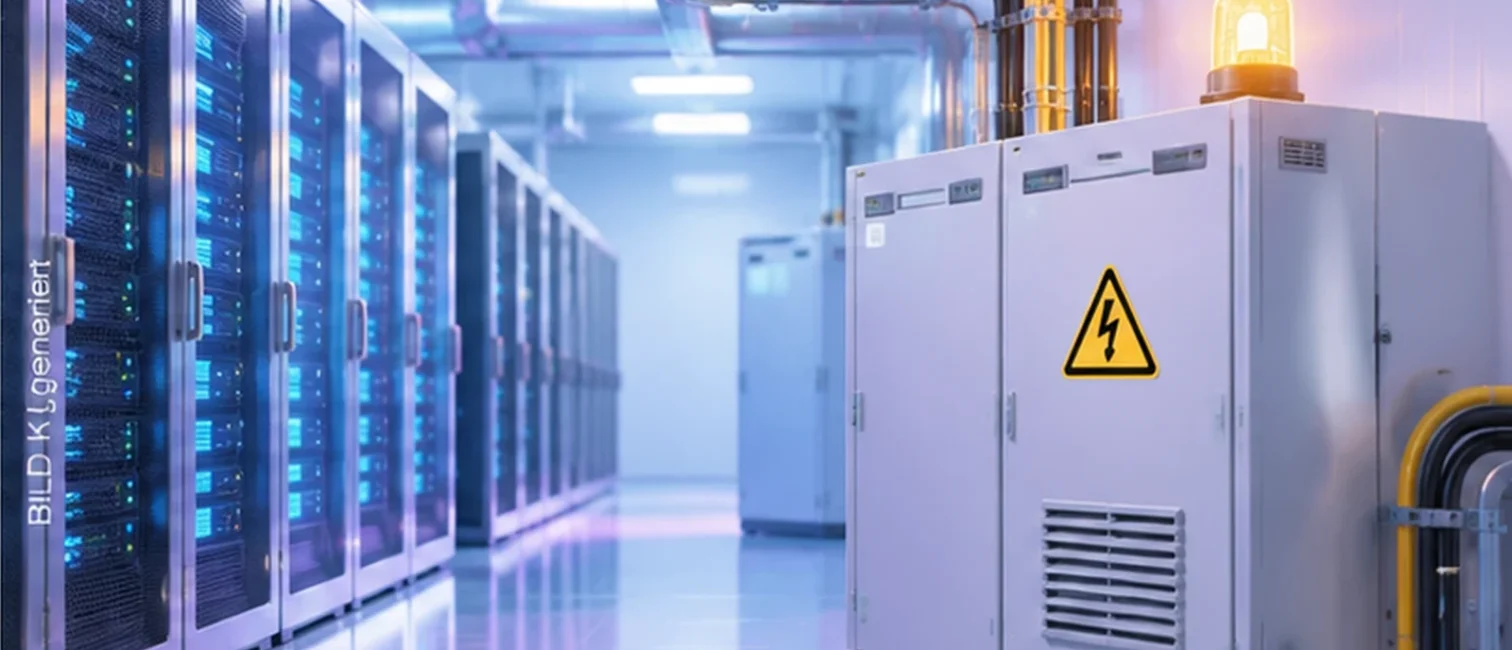
Eine fehlerhafte Steuerung der Notstromversorgung hat im Oktober einen mehrstündigen Google-Cloud-Ausfall in London verursacht. Ein inzwischen veröffentlichter Untersuchungsbericht zeigt, warum die redundanten Stromversorgungssysteme den Vorfall nicht verhindern konnten. Auch Dienste außerhalb der unmittelbar betroffenen Verfügbarkeitszone waren zeitweise beeinträchtigt.
Am 20. Oktober 2026 kam es in der Google-Cloud-Region europe-west2 zu erheblichen Betriebsstörungen. Auslöser war eine Unterbrechung der Stromversorgung in einem Rechenzentrum, das die Verfügbarkeitszone europe-west2-b beherbergt.
Infolge der Störung verloren Server, Speichersysteme und Netzwerkkomponenten ihre Stromversorgung. Dadurch wurden zahlreiche Cloud-Ressourcen vorübergehend unerreichbar.
Nach Angaben von Google dauerten die wesentlichen Auswirkungen sechs Stunden und acht Minuten. Betroffene Kunden konnten während dieser Zeit teilweise nicht auf virtuelle Maschinen, Datenbanken und weitere Cloud-Dienste zugreifen.
Am 4. November veröffentlichte Google einen ausführlichen Incident Report. Darin beschreibt der Konzern die technischen Ursachen und die geplanten Verbesserungen an der Infrastruktur.
Das betroffene Rechenzentrum verfügt grundsätzlich über redundante Stromversorgungssysteme. Zum Zeitpunkt des Vorfalls befand sich die Anlage jedoch in einem vorübergehend eingeschränkten Wartungszustand.
Nach Problemen bei einem vorausgegangenen Generatortest war einer der beiden regulären Strompfade für Reparaturarbeiten getrennt worden. Der verbleibende Versorgungspfad übernahm die vollständige Last.
Als außerhalb des Rechenzentrums ein unterirdisches Stromkabel ausfiel, hätte die Notstromversorgung automatisch übernehmen müssen. Genau dieser Wechsel funktionierte nicht wie vorgesehen.
Google führt den Fehler auf eine Kombination aus ungünstiger Spannungsmessung und fehlerhafter Konfiguration der speicherprogrammierbaren Steuerung zurück.
Die Steuerung erkannte weiterhin Spannung an einem externen Einspeisepunkt. Obwohl dieser Strompfad im Rechenzentrum bereits getrennt war, interpretierte das System die Situation als verfügbare Stromversorgung.
Deshalb erhielten die Notstromgeneratoren keinen automatischen Startbefehl.
Zunächst hielten unterbrechungsfreie Stromversorgungen mit ihren Batterien den Betrieb aufrecht. Nachdem deren Reserven erschöpft waren, verloren die betroffenen Systeme ihre elektrische Versorgung.
Der Vorfall zeigt, dass auch mehrfach ausgelegte technische Systeme durch gemeinsame Steuerungsfehler ausfallen können.
Besonders stark betroffen waren virtuelle Maschinen und zonale Speicherressourcen in europe-west2-b. Dazu gehörten Google Compute Engine sowie Persistent Disk und Hyperdisk.
Auch weitere Dienste meldeten Einschränkungen. Unter anderem waren Google Kubernetes Engine, Cloud SQL, Cloud Storage, BigQuery und Cloud Run in unterschiedlichem Umfang betroffen.
Der Ausfall blieb nicht auf die unmittelbar betroffene Zone beschränkt. Als Anwendungen und interne Cloud-Dienste versuchten, ihre Arbeitslast in andere Zonen zu verlagern, entstanden zusätzliche Belastungen.
Dadurch kam es in weiteren Teilen der Region London zu erhöhten Fehlerraten, längeren Antwortzeiten und Verzögerungen bei der Verarbeitung.
Google zufolge wurden außerhalb der Region europe-west2 keine Auswirkungen festgestellt.
Die Wiederherstellung der Stromversorgung allein reichte nicht aus, um alle Dienste unmittelbar wiederherzustellen. Google musste zunächst unter anderem die Integrität betroffener Speichersysteme überprüfen und anschließend virtuelle Maschinen und weitere Infrastrukturkomponenten kontrolliert starten.
Einzelne Datenbankdienste benötigten deshalb länger für ihre vollständige Wiederherstellung.
Nach dem Vorfall überprüfte Google die Konfiguration der Steuerungssysteme und korrigierte die Probleme bei der Erkennung des Stromversorgungszustands.
Der Konzern kündigte außerdem technische und organisatorische Verbesserungen an. Dazu zählen zusätzliche Überprüfungen der Infrastruktur sowie umfangreichere Tests für den vollständigen Stromausfall einer Rechenzentrumsanlage.
Auch die Wiederherstellung von Compute- und Speicherressourcen soll verbessert werden.
Ein weiterer Schwerpunkt liegt auf der automatischen Fehlererkennung bei regionalen Speicherressourcen. Der ungewöhnliche Verlauf des Ausfalls hatte dazu geführt, dass einige Wiederherstellungsmechanismen nicht wie erwartet funktionierten.
Die Untersuchung betrifft somit nicht nur die Gebäudetechnik, sondern auch das Verhalten verteilter Cloud-Dienste beim Ausfall einer vollständigen Zone.
Für Unternehmen ist der Google-Cloud-Ausfall ein Beispiel dafür, dass die Verfügbarkeit einer Cloud-Plattform wesentlich von der zugrunde liegenden physischen Infrastruktur abhängt.
Redundante Systeme reduzieren Risiken, garantieren jedoch keine unterbrechungsfreie Verfügbarkeit. Besonders wichtig ist, wie Anwendungen reagieren, wenn eine komplette Verfügbarkeitszone plötzlich nicht mehr erreichbar ist.
Unternehmen sollten daher berücksichtigen, ob geschäftskritische Anwendungen auf mehrere Zonen verteilt sind und ob die entsprechenden Wiederherstellungsmechanismen ausreichend getestet wurden.
Auch die Kapazitäten alternativer Zonen spielen eine Rolle. Wie der Vorfall zeigt, können gleichzeitige Verlagerungen zahlreicher Workloads neue Engpässe verursachen.
Wer seine IT-Infrastruktur in die Cloud migriert, sollte Ausfallszenarien deshalb bereits bei der Architekturplanung berücksichtigen.
Der Vorfall verdeutlicht zudem, warum die Abhängigkeit von einzelnen Regionen und Technologien eine strategische Entscheidung darstellt. Technische Redundanz muss mit klaren Wiederanlaufverfahren und regelmäßigen Tests verbunden werden.
Der veröffentlichte Incident Report macht die Ursachen des Londoner Ausfalls nachvollziehbar. Entscheidend war nicht allein die externe Stromunterbrechung. Erst das Zusammenspiel aus Wartungszustand, fehlerhafter Notstromsteuerung und den anschließenden Wiederherstellungsproblemen führte zu den umfangreichen Auswirkungen.
Für Cloud-Kunden unterstreicht das Ereignis die Bedeutung belastbarer Notfallkonzepte. Auch bei großen Infrastrukturbetreibern können seltene Fehlerkombinationen die Verfügbarkeit erheblich beeinträchtigen.
Quellen:
Google Cloud, Incident Report zum Ausfall in europe-west2, 04.11.2026
Google Cloud, Service Health History
Weitere Entwicklungen rund um Cloud-Infrastruktur, Rechenzentren und IT-Betrieb behandelt der IT-Dock Newsletter. Im Mittelpunkt stehen technische Hintergründe und ihre Bedeutung für Unternehmensentscheidungen.
Kommentare (0)
Noch keine Kommentare vorhanden.