
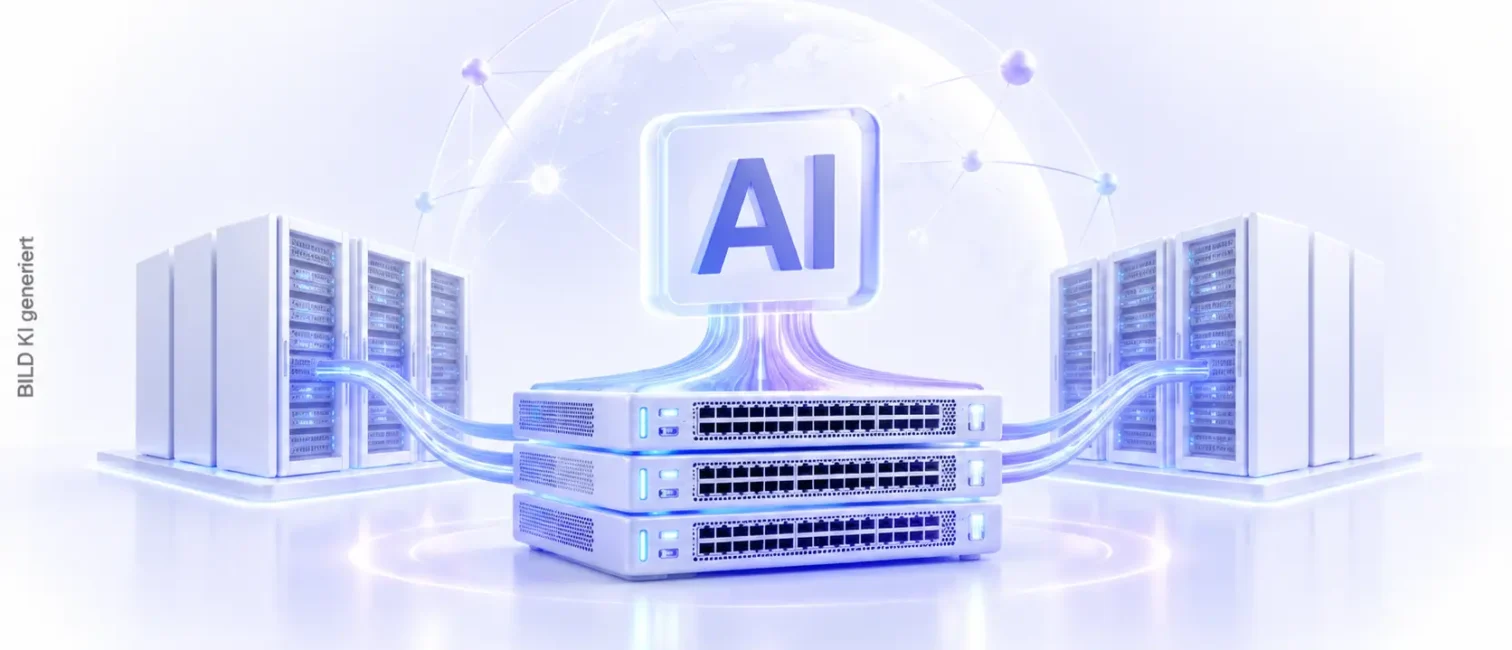

HPE und Oracle erweitern ihre Zusammenarbeit beim Aufbau großer KI-Infrastrukturen. Oracle plant, HPE Juniper Networking über mehrere Jahre weltweit in seinen KI-Rechenzentren einzusetzen. Im Fokus stehen Netzwerke für große GPU-Cluster, bei denen Bandbreite, Latenz und Congestion Management entscheidend werden.
Die Ankündigung stammt vom 2. September 2026 und ist damit keine Tagesmeldung mehr. Sie zeigt jedoch exemplarisch, wie stark KI-Infrastruktur inzwischen auch das Netzwerkdesign verändert. Oracle baut seine Cloud-Kapazitäten derzeit deutlich aus. Im jüngsten Quartal kamen nach Unternehmensangaben 850 Megawatt zusätzliche Datacenter-Kapazität hinzu.
Oracle baut KI-Netzwerke mit HPE Juniper aus
HPE Juniper Networking kommt bereits in Teilen der Oracle Cloud Infrastructure zum Einsatz. Router der Serien MX und PTX unterstützen Bereiche des Edge-Netzwerks. QFX-Switches werden auf mehreren Ebenen der regionalen Datacenter-Fabric eingesetzt.
Diese Zusammenarbeit soll nun ausgeweitet werden. Vorgesehen ist ein potenziell mehrjähriger Einsatz von PTX- und MX-Routern sowie QFX- und EX-Switches in Oracle-Rechenzentren weltweit. Hinzu kommen Netzwerk-Support und Finanzierungsmöglichkeiten.
HPE und Oracle arbeiten bereits seit mehr als zehn Jahren im Netzwerkbereich zusammen. Durch den Ausbau der OCI AI Supercluster gewinnt diese Verbindung nun für die KI-Infrastruktur an Bedeutung.
Warum große KI-Cluster andere Netzwerke brauchen
Bei klassischen Unternehmensanwendungen verteilt sich Datenverkehr häufig zwischen Clients und Servern. Große KI-Cluster erzeugen dagegen erhebliche Datenströme zwischen den beteiligten Rechenknoten.
Beim Training großer Modelle müssen GPUs regelmäßig Daten austauschen und ihre Berechnungen synchronisieren. Verzögerungen im Netzwerk können deshalb dazu führen, dass Beschleuniger auf Daten warten. Netzwerkleistung beeinflusst damit auch die Auslastung kostspieliger GPU-Ressourcen.
HPE nennt insbesondere Bandbreite, Latenz, Congestion Management und Fehlerbehebung als Anforderungen, die mit wachsenden GPU-Clustern wichtiger werden.
Dass die Nachfrage zunimmt, zeigt auch HPEs jüngster Quartalsbericht. Der Umsatz mit Datacenter Networking erreichte im dritten Geschäftsquartal 2026 rund 382 Millionen US-Dollar und lag damit 112,2 Prozent über dem Vorjahreszeitraum. HPE führt die hohe Nachfrage unter anderem auf Investitionen von Hyperscalern und Cloud-Anbietern in KI-Infrastruktur zurück.
RoCEv2 verbindet GPUs über Ethernet
Eine zentrale Rolle in Oracles Ausbau spielt RoCEv2, kurz für RDMA over Converged Ethernet Version 2. Die Technik ermöglicht direkten Speicherzugriff zwischen Systemen über ein Ethernet-Netzwerk und reduziert dabei die Beteiligung der CPU an der Datenübertragung.
Das kann Latenzen und zusätzlichen Verarbeitungsaufwand reduzieren. Für verteilte KI-Workloads ist das relevant, weil große Mengen an Daten schnell zwischen den beteiligten Rechenknoten übertragen werden müssen.
Die neuesten QFX-Switches sollen bei Oracle hohe Portdichten, dynamisches Load Balancing und Funktionen für Congestion Management bereitstellen. HPE positioniert Ethernet damit als Backend-Netzwerk für große RoCEv2-basierte KI-Cluster.
RoCEv2 allein garantiert allerdings kein leistungsfähiges KI-Netzwerk. Architektur, Switch-Konfiguration, Traffic-Verteilung und Überwachung bleiben entscheidend für den tatsächlichen Betrieb.
HPE und Oracle erweitern die Netzwerk-Telemetrie
Neben den Switches und Routern arbeiten beide Unternehmen an einer tieferen Überwachung der Netzwerk-Fabric. Ziel ist es, Probleme früher zu erkennen und deren Auswirkungen auf GPU-Cluster zu begrenzen.
Die Telemetrie soll unter anderem den Aufbau von Warteschlangen, Paketverluste, ungleich verteilten Datenverkehr und eine Verschlechterung einzelner Komponenten sichtbar machen. Solche Informationen können helfen, Engpässe zu lokalisieren, bevor sie größere Teile eines Clusters beeinträchtigen.
Gerade bei großen KI-Installationen wird Observability damit zu einem wichtigen Bestandteil des Netzwerkdesigns. Es reicht nicht, ausreichend Bandbreite bereitzustellen. Betreiber müssen auch erkennen können, an welcher Stelle Datenströme ausgebremst werden.
Warum Netzwerkprobleme bei KI besonders teuer werden
Der Ausbau bei Oracle verdeutlicht eine wirtschaftliche Besonderheit von KI-Infrastruktur. Ein Netzwerkengpass betrifft nicht nur die Datenübertragung. Er kann gleichzeitig verhindern, dass teure GPU-Ressourcen vollständig ausgelastet werden.
Damit verschiebt sich die Rolle des Netzwerks. Switching, Routing und Telemetrie werden stärker mit der Planung von Compute-Ressourcen verknüpft. Für Betreiber großer KI-Umgebungen müssen Server, Beschleuniger, Storage und Netzwerk deshalb als gemeinsame Architektur betrachtet werden.
HPE sieht diese Nachfrage bereits in den eigenen Zahlen. Nach Angaben des Unternehmens lagen die Bestellungen für Routing und Datacenter Switching im vergangenen Quartal deutlich über dem Umsatz. Der Auftragsbestand erreichte einen Höchststand.
Zur Vereinbarung mit Oracle gehört außerdem ein finanzieller Bestandteil: HPE hat Oracle Bezugsrechte für HPE-Aktien eingeräumt. Weitere Konditionen nennt die öffentliche Ankündigung nicht.
AI Networking wird zum eigenen Infrastrukturthema
Die Zusammenarbeit zwischen HPE und Oracle zeigt, dass sich der Ausbau von KI-Rechenzentren nicht auf GPUs und Server beschränkt. Mit steigender Clustergröße wachsen auch die Anforderungen an Switching, Routing, Telemetrie und Congestion Management.
Für klassische Mittelstands-IT sind Cluster in dieser Größenordnung zwar kaum unmittelbar relevant. Die zugrunde liegende Entwicklung ist dennoch interessant: Mit zunehmender Nutzung eigener KI-Infrastruktur werden Netzwerkarchitektur und Compute-Leistung enger miteinander verbunden.
AI Networking entwickelt sich damit zu einem eigenen Infrastrukturthema. Wie stark sich Technologien wie RoCEv2 auch außerhalb großer Cloud- und Hyperscale-Umgebungen durchsetzen, hängt von den jeweiligen KI-Workloads und deren Skalierung ab.
Weitere Entwicklungen zu Netzwerk, Datacenter und KI-Infrastruktur ordnet IT-Dock regelmäßig im Newsletter ein: https://it-dock.de/#newsletter.


Kommentare (0)
Noch keine Kommentare vorhanden.