Vibe Coding: Definition, Tools & Risiken für Unternehmen
Dieser Ratgeber ordnet Vibe Coding sachlich ein: was der Begriff bedeutet, wie er funktioniert, welche Tools dahinterstecken und wo die Chancen und Grenzen liegen.
Open Source KI ► ✓ Lizenzen von Llama bis Mistral ✓ Pflichten nach EU AI Act ✓ Erfahrungen aus dem lokalen Betrieb

Anzeige | Partnerbeitrag von SEQIS
Open Source KI meint Modelle und Werkzeuge, deren Bestandteile offenliegen und die Sie nutzen, verändern und weitergeben dürfen. Der Begriff klingt eindeutig. Er steht in der Praxis für vier verschiedene Dinge, die auf vier verschiedenen Ebenen liegen.
Wer im Unternehmen darüber entscheidet, stolpert genau darüber. Eine Suche nach dem Begriff liefert mal Programmbibliotheken für Entwickler, mal fertige Chatbots zum Herunterladen. Beides trägt denselben Namen und hat wenig miteinander zu tun.
Eine Auswertung der Linux Foundation, in Auftrag gegeben von Meta, kommt auf 89 Prozent: So viele Organisationen mit KI-Einsatz nutzen dabei Open-Source-Komponenten. 63 Prozent arbeiten direkt mit einem offenen Modell. Den Auftraggeber sollten Sie mitdenken, die Richtung dürfte stimmen. Für die meisten Unternehmen lautet die Frage also nicht mehr, ob offene KI zum Einsatz kommt. Sie lautet: auf welcher Ebene und unter welcher Lizenz.
Dieser Beitrag sortiert die Ebenen, ordnet die Lizenzen ein und klärt, was die KI-Verordnung von Ihnen verlangt.
Open Source KI ist nicht gleich Open Source Modell.
Anwendungen, Laufzeitumgebungen, Modelle und Frameworks sind vier verschiedene Ebenen – mit eigenen Lizenzen und Verantwortlichkeiten.
Open Weights ist nicht automatisch Open Source.
Herunterladbare Modellgewichte allein reichen nach der Definition der Open Source Initiative nicht aus.
Die Lizenz gehört zum Modell, nicht zur Modellfamilie.
Selbst innerhalb von Mistral, Qwen oder anderen Familien können unterschiedliche Bedingungen gelten.
Lokaler Betrieb schützt sensible Daten, verlagert aber Verantwortung ins eigene Haus.
Hardware, Updates, Sicherheitslücken und Administration gehören in die Kostenrechnung.
Der EU AI Act macht keine pauschale Ausnahme für Open Source KI.
Welche Pflichten ein Unternehmen treffen, hängt vor allem vom konkreten Einsatzzweck und der eigenen Rolle ab.
Bei klassischer Software ist die Lage einfach. Der Quellcode liegt offen, und eine Lizenz erlaubt jedem, ihn zu nutzen und verändert weiterzugeben. Bei KI reicht das nicht, denn ein Modell hat drei Bestandteile: den Code, die trainierten Gewichte und die Daten, aus denen es gelernt hat. Eine Lizenz deckt meist nur einen davon ab. Wer die Gewichte herunterladen darf, weiß deswegen noch nicht, womit das Modell trainiert wurde.
Die Open Source Initiative hat deshalb im Oktober 2024 die Open Source AI Definition in Version 1.0 vorgelegt. Sie verlangt, dass Sie ein Modell nutzen, untersuchen, verändern und weitergeben dürfen. Außerdem müssen Sie genug über die Trainingsdaten erfahren, um das Ergebnis im Prinzip nachbauen zu können. Nur wenige Modelle erfüllen das vollständig.
Viele bekannte Modelle sind Open Weights. Sie laden die trainierten Gewichte herunter und betreiben das Modell selbst. Die Trainingsdaten bleiben unter Verschluss, und die Lizenz zieht Grenzen.
Die Llama 4 Community License verlangt eine Sonderlizenz von Meta, sobald ein Dienst zum Erscheinungsdatum der Modellversion mehr als 700 Millionen monatlich aktive Nutzer erreicht. Für den deutschen Mittelstand spielt diese Schwelle keine Rolle. Zwei andere Klauseln derselben Lizenz schon: Abgeleitete Modelle müssen den Namensbestandteil Llama tragen und einen Hinweis „Built with Llama“ zeigen. Und bei den multimodalen Llama-4-Modellen räumt Meta Unternehmen mit Hauptsitz in der Europäischen Union die Rechte ausdrücklich nicht ein. Wer in Deutschland sitzt und Bild oder Audio verarbeiten will, scheidet damit aus.
Wer im Einkauf oder in der Revision eine Liste offener Komponenten führt, sollte Open Source und Open Weights deshalb getrennt führen.
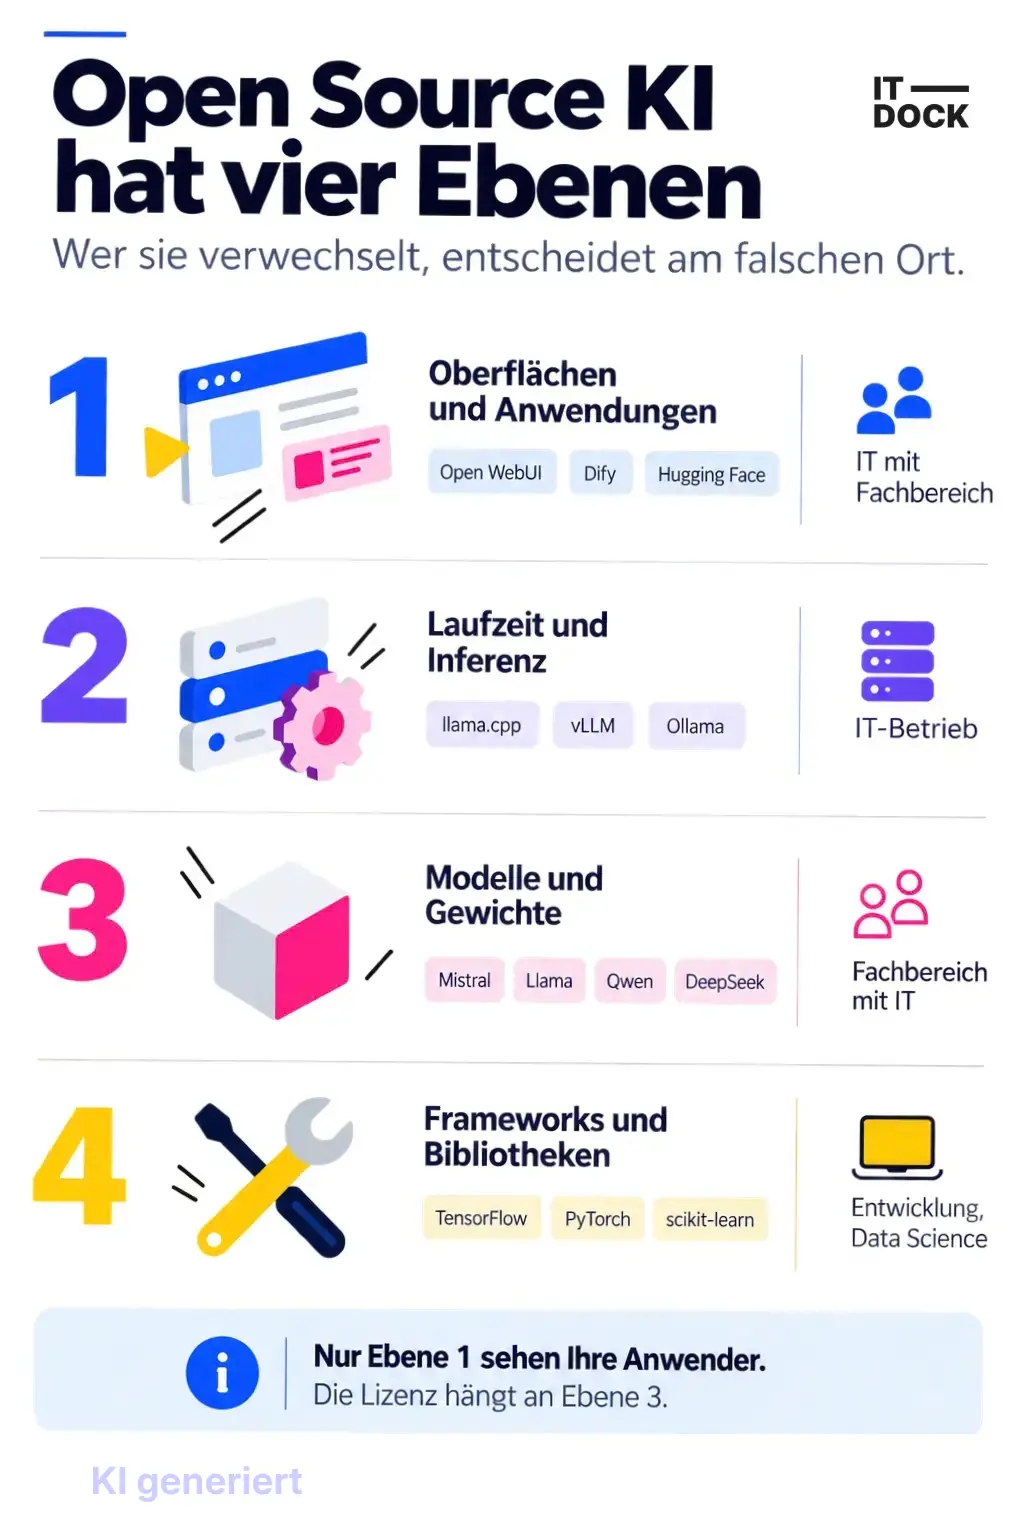
Hier liegt die eigentliche Verwirrung. Übersichten zum Thema mischen vier Ebenen. Jede erfüllt eine eigene Aufgabe, und im Unternehmen verantwortet sie jemand anderer. Was als eine Plattform daherkommt, ist meist ein Stapel aus vier.
Ganz unten liegen die Frameworks und Bibliotheken. TensorFlow, PyTorch, JAX, scikit-learn und MLflow sind Werkzeuge, mit denen Fachleute Modelle trainieren und überwachen. Wer ein fertiges Sprachmodell einsetzen will, kommt mit ihnen nie in Berührung.
Darüber liegen die Modelle selbst, also die trainierten Gewichte. Mistral, Llama, Qwen und DeepSeek gehören hierher, große Sprachmodelle, im Fachjargon LLM für Large Language Model. Sie bringen die Sprachfähigkeit mit, laufen aber nicht von allein.
Die dritte Ebene führt das Modell aus. llama.cpp, vLLM und Ollama sorgen dafür, dass ein LLM auf vorhandener Infrastruktur arbeitet. Diese Ebene bestimmt, wie schnell eine Antwort kommt und wie viel Speicher das Ganze belegt.
Ganz oben stehen die Oberflächen und Anwendungen. Open WebUI, Dify und das Ökosystem rund um Hugging Face geben Mitarbeitern Zugang und binden Firmendokumente an. Nur diese Ebene sehen Anwender, die anderen drei bleiben unsichtbar.
| Ebene | Beispiele | Aufgabe | Wer entscheidet |
|---|---|---|---|
| Frameworks und Bibliotheken | TensorFlow, PyTorch, JAX, scikit-learn, MLflow | Modelle trainieren, anpassen, überwachen | Entwicklung, Data Science |
| Modelle und Gewichte | Mistral, Llama, Qwen, DeepSeek, Gemma | die Sprachfähigkeit selbst | Fachbereich mit IT |
| Laufzeit und Inferenz | llama.cpp, vLLM, Ollama | LLM auf vorhandener Infrastruktur ausführen | IT-Betrieb |
| Oberflächen und Anwendungen | Open WebUI, Dify, Hugging Face | Zugang schaffen, Firmenwissen anbinden | IT mit Fachbereich |
Die Trennung klärt, wer im Haus entscheidet. Ein Modellwechsel ist eine Fachentscheidung und in wenigen Tagen erledigt. Ein Wechsel der Laufzeitumgebung betrifft die Infrastruktur und zieht Tests nach sich. Sie schützt außerdem vor Abhängigkeiten: Wer alle vier Ebenen als Paket von einer Plattform bezieht, hat dieselbe Bindung wie bei einem Clouddienst, nur mit mehr Aufwand.
Der Markt bewegt sich schnell, die Lizenzen bewegen sich langsam. Die Übersicht gibt den Stand vom September 2026 wieder.
| Modellfamilie | Anbieter | Lizenz der offenen Modelle | Nach OSI-Maßstab offen? | Worauf Sie achten sollten |
|---|---|---|---|---|
| DeepSeek | DeepSeek, China | MIT | ja | frühe Versionen liefen unter eigener Lizenz mit Nutzungsverboten |
| Phi | Microsoft, USA | MIT | ja | die Hinweise zu verantwortlichem Einsatz sind Empfehlung, keine Auflage |
| OLMo | Allen Institute, USA | Apache 2.0, Trainingsdaten unter ODC-BY | ja | einzige Familie mit offen abrufbaren Trainingsdaten |
| Whisper | OpenAI, USA | MIT | ja | Lizenzangaben auf Hugging Face widersprechen sich zwischen Varianten |
| gpt-oss | OpenAI, USA | Apache 2.0 | ja | |
| Mistral | Mistral AI, Frankreich | gemischt, Apache 2.0 bei Small, Large und Ministral | teilweise | Medium, Codestral und die OCR-Reihe laufen anders |
| Qwen | Alibaba, China | gemischt, Apache 2.0 bei mehreren Modellen | teilweise | die größten Modelle haben eigene Lizenzen mit Namensnennungspflicht |
| GLM | Z.ai, China | MIT bis Version 5.2, danach eigene Lizenz | teilweise | die Eigenlizenz zielt auf sehr große Plattformbetreiber |
| Gemma | Google, USA | eigene Bedingungen bis Version 3, Apache 2.0 ab Version 4 | teilweise | ältere Versionen mit Nutzungsverboten und Zugangssperre |
| Llama | Meta, USA | Llama 4 Community License | nein | Namenspflicht, MAU-Schwelle, EU-Ausschluss bei multimodalen Modellen |
Die Spalte ganz rechts trägt den wichtigsten Befund: Die Lizenz gehört zum einzelnen Modell, nicht zur Familie. Mistral vergibt Apache 2.0 für Small und Large, hält Codestral und die OCR-Modelle aber geschlossen. Qwen nutzt drei verschiedene Lizenzen nebeneinander. Gemma war bis Version 3 eine Eigenlizenz mit Nutzungsverboten und ist seit Version 4 Apache 2.0. GLM lief bis 5.2 unter MIT und hat danach gewechselt. Wer eine Familie pauschal freigibt, gibt früher oder später etwas frei, das nicht freigegeben war.
Ein zweiter Punkt betrifft die Nachvollziehbarkeit. Nur OLMo vom Allen Institute veröffentlicht auch die Trainingsdaten, abrufbar als Dolma-Datensätze unter ODC-BY. Wenn Sie gegenüber einer Revision oder einem Auditor belegen müssen, womit ein Modell gelernt hat, bleibt praktisch nur diese Familie.
Als Filter taugt die Herkunft der Modelle dagegen kaum. Die saubersten Lizenzen verteilen sich quer über die Länder: MIT bei DeepSeek aus China und bei Phi aus den USA, Apache 2.0 bei OLMo aus den USA und bei Teilen von Mistral aus Frankreich. Die restriktivste Lizenz in dieser Übersicht kommt aus den USA. Wer chinesische Modelle ausschließen will, braucht dafür Argumente aus Lieferkette und Governance. Die Lizenzqualität liefert sie nicht.
Es gibt sie nicht. Die Frage führt in die Irre, weil die Anforderungen zu weit auseinanderliegen. Nützlicher sind vier Kriterien.
Das erste Kriterium ist die deutsche Sprachqualität. Benchmarks messen fast immer Englisch. Ein Modell, das in englischen Tests vorn liegt, kann im Deutschen umständlich formulieren, Fachbegriffe falsch beugen oder ins Englische kippen. Testen Sie deshalb mit eigenen Texten aus dem Arbeitsalltag.
Zweitens die Lizenz. Prüfen Sie vor dem Test, ob sie Ihren geplanten Einsatz deckt. Ein Modell wieder auszubauen, kostet erheblich mehr als die Prüfung vorher.
Der Speicherbedarf kommt als drittes dazu. Er bestimmt die Hardware und damit den größten Kostenblock.
Bleibt der Pflegezustand des Projekts. Ein Modell ohne aktive Weiterentwicklung wird zum Problem, sobald eine Sicherheitslücke auftaucht oder ein Format sich ändert.
| Anwendungsfall | Übliche Modellgröße | Speicherbedarf, grob |
|---|---|---|
| Texte zusammenfassen, Dokumente durchsuchen | 7 bis 14 Milliarden Parameter | ab etwa 8 GB |
| Firmenwissen per RAG beantworten | 14 bis 32 Milliarden | ab etwa 24 GB |
| Code schreiben und prüfen | 14 bis 32 Milliarden | ab etwa 24 GB |
| Spracherkennung, Übersetzung | Spezialmodelle | wenige GB |
| Bilderkennung auf Geräten | unter 100 Millionen | wenige GB |
Für viele Aufgaben reicht ein kleines Modell. Eine Bilderkennung kommt mit rund 70 Millionen Parametern aus und braucht keine 70 Milliarden. Wer immer zum größten verfügbaren Modell greift, zahlt für Hardware und Strom, ohne ein besseres Ergebnis zu bekommen.
Die Open-Source-Ausnahme der KI-Verordnung richtet sich an den Anbieter des Modells. Wer Mistral im eigenen Haus betreibt, ist Betreiber und fällt nicht darunter. Diese Zuordnung geht in vielen Übersichten verloren.
Die Verordnung kennt zwei getrennte Ausnahmen, die häufig verwechselt werden. Artikel 2 Absatz 12 nimmt quelloffene KI-Systeme vom Anwendungsbereich aus. Das gilt jedoch nicht, wenn das System als Hochrisiko-System in Verkehr kommt oder unter die verbotenen Praktiken nach Artikel 5 oder die Transparenzpflichten nach Artikel 50 fällt. Artikel 53 Absatz 2 regelt etwas anderes, nämlich die Pflichten der Anbieter von Modellen mit allgemeinem Verwendungszweck. Für Unternehmen zählt meist die zweite Regel, weil die großen Sprachmodelle darunter fallen.
Artikel 53 Absatz 1 legt vier Pflichten für Anbieter solcher Modelle fest:
Absatz 2 befreit Anbieter offener Modelle von den ersten beiden Punkten, also von Buchstabe a und b. Dafür müssen Lizenz, Parameter und Architektur öffentlich zugänglich sein. Die Urheberrechtsstrategie und die Zusammenfassung der Trainingsinhalte bleiben bestehen. Viele Darstellungen im Netz verkürzen das und behaupten eine umfassende Befreiung. Für Sie hat die genaue Lesart einen praktischen Wert: Sie dürfen bei jedem offenen Modell nach der Zusammenfassung der Trainingsinhalte fragen, auch wenn der Anbieter sich auf die Ausnahme beruft.
Die Ausnahme greift außerdem gar nicht, sobald ein Modell als solches mit systemischem Risiko gilt. Die Schwelle liegt nach Artikel 51 Absatz 2 bei mehr als 10 hoch 25 Gleitkommaoperationen für das Training. Oberhalb davon treffen den Anbieter alle Pflichten, unabhängig von der Lizenz.
Die Erwägungsgründe der Verordnung ziehen eine weitere Grenze. Sobald ein Anbieter eine offene Komponente gegen Entgelt abgibt oder anders zu Geld macht, verliert er die Privilegierung. Ein Modell einfach auf GitHub oder Hugging Face bereitzustellen, zählt dabei nicht als Monetarisierung.
Über Ihre Pflichten entscheidet der Einsatzzweck, und die Lizenz spielt dabei keine Rolle. Ein Chatbot für die interne Recherche ist etwas anderes als ein System, das über Bewerbungen mitentscheidet. Der zweite Fall fällt in den Hochrisikobereich. Dann müssen Sie dokumentieren, protokollieren und einen Menschen die Entscheidungen prüfen lassen.
Die Pflicht zur KI-Kompetenz gilt seit Februar 2025 und trifft jeden, der KI im Unternehmen einsetzt. Ihre Mitarbeiter müssen verstehen, was das System leistet und wo es irrt. Ein Managementsystem nach ISO/IEC 42001 bildet diese Anforderungen ab und lässt sich zertifizieren.
Die Pflichten für Modelle mit allgemeinem Verwendungszweck gelten seit dem 2. August 2025. Die zugehörigen Geldbußen nach Artikel 101 greifen erst seit dem 2. August 2026. Beides trifft in erster Linie die Anbieter. Sie merken es dort, wo Sie Nachweise über ein eingesetztes Modell brauchen und der Anbieter sie liefern muss.
Am 27. Juli 2026 ist die Verordnung (EU) 2026/1744 in Kraft getreten, bekannt als Digital Omnibus. Sie verschiebt die Anforderungen an Hochrisiko-Systeme nach hinten. Die übrigen Fristen bleiben, wo sie waren.
| Stichtag | Was gilt | Wen es trifft |
|---|---|---|
| 2. Februar 2025 | verbotene Praktiken nach Artikel 5, Pflicht zur KI-Kompetenz nach Artikel 4 | alle |
| 2. August 2025 | Pflichten für Modelle mit allgemeinem Verwendungszweck, Artikel 53 | Modellanbieter |
| 2. August 2026 | Geldbußen nach Artikel 101 | Modellanbieter |
| 2. Dezember 2026 | zwei später eingefügte Verbotstatbestände | alle |
| 2. Dezember 2027 | Hochrisiko-Anforderungen für die Anwendungsfälle aus Anhang III, verschoben vom August 2026 | Betreiber und Anbieter |
| 2. August 2028 | Hochrisiko-Anforderungen für regulierte Produkte nach Anhang I | Betreiber und Anbieter |
Der Aufschub bei den Hochrisiko-Pflichten verschafft Zeit für die Vorbereitung. Er hebt die Pflichten nicht auf.
Wer ein offenes Modell selbst betreibt, tauscht laufende Tokenkosten gegen eigene Verantwortung. Das Modell kostet nichts. Der Betrieb kostet Hardware, Strom, Administration und die Pflege aller Komponenten, aus denen der Stack besteht.
Die SEQIS Group betreibt lokale Sprachmodelle seit Herbst 2023 im eigenen Haus. Aus dieser Erfahrung ist der razzfazz.ai Stack entstanden, den inzwischen auch Kunden einsetzen. Von den ersten Versuchen bis zur fertigen Integration vergingen rund zwei Jahre.
Die Auswahl läuft nicht über die Modellfamilie, sondern über das Format. Im Betrieb sind ausschließlich Modelle im GGUF-Format, wie sie auf Hugging Face veröffentlicht werden. Ausgeführt werden sie über llama.cpp. Damit gilt eine einfache Regel: Was llama.cpp unterstützt, läuft — und das ist der weit überwiegende Teil des offenen Modellfelds. Eine Liste der eingesetzten Modelle wäre lang und nach drei Monaten falsch.
Drei Modelltypen laufen parallel, alle als GGUF. Die Chat- und Instruktionsmodelle erledigen die Textarbeit; wo das Modell es mitbringt, lesen sie auch Bilder und Videos. Dazu kommen Embedding-Modelle, die Dokumente in Vektoren übersetzen, und Reranking-Modelle, die die Treffer einer Suche nach Relevanz sortieren. Ohne die letzten beiden funktioniert keine brauchbare RAG-Anbindung. Bildgenerierung ist bislang bewusst nicht Teil des Stacks.
Die Parametergröße richtet sich nach der Hardware, nicht nach dem Ehrgeiz. Auf 96 GB Unified Memory laufen Modelle bis rund 120 Milliarden Parameter bei Q8-Quantisierung. Die Quantisierung ist dabei der eigentliche Hebel: Sie verkleinert die Gewichte und senkt den Speicherbedarf um ein Vielfaches, zulasten von etwas Genauigkeit. Für die meisten Aufgaben ist dieser Tausch gut investiert.
Aussortiert wurden Modelle bisher weniger wegen ihrer Qualität als wegen ihres Zeitpunkts. Bringt ein Anbieter eine neue Modellarchitektur heraus, dauert es, bis llama.cpp sie unterstützt im Regelfall ein paar Wochen. Wer den Stack plant, sollte diesen Versatz einkalkulieren statt auf Ankündigungen zu terminieren.
Das Management der Modelle, die Verwaltung der Workeragents, das Usagemonitoring aber auch das Loadbalancing übernimmt der rzfz.ai LLM Manager als zentrale Komponente des Stacks. Der LLM Manager erlaubt transparente Skalierung durch ein Master/Workerkonzept, bei dem zusätzliche Inferenzworker einfach hinzugefügt werden können und damit die Kapazität für parallele Requests linear ansteigt.
Die Administratoren können weitere Modelle ausprobieren, der darunterliegende Stack bleibt kuratiert. Er besteht aus Open WebUI als Oberfläche, einer RAG-Anbindung für Firmendokumente und einer Websuche, die Anfragen neutralisiert, bevor sie das Netzwerk verlassen. Eine Frage nach dem Vermögensstand einer Firma geht dann als allgemeine Frage nach dieser Firma hinaus. Die eigentliche Auswertung passiert lokal.
Über alle Fälle hinweg ist das Muster dasselbe: Die KI liefert die Vorarbeit, ein Expert-in-the-Loop (EitL) entscheidet. Vier Beispiele aus dem eigenen Betrieb.
Der Nutzen entsteht dort, wo Firmenwissen ins Spiel kommt. Große Modelle haben öffentlich verfügbare Texte längst gelesen. Was ihnen fehlt, sind interne Preislisten, Projektdokumentation und Wissensdatenbanken. Diese Daten lassen sich einfach lokal anbinden, ohne dass sie das Haus verlassen. Und auch Cloud-Modelle müssten um dieses interne Wissen ergänzt werden.
Die Frage, die uns dabei am häufigsten gestellt wird, lautet: Kann man KI-generierten Ergebnissen blind vertrauen? Nein, und das ist auch nicht das Ziel. Man prüft sie. Prüfen ist billiger als Schreiben.
Kleinere lokale Modelle erreichen die Qualität großer Cloud-Modelle nicht. Wer die beste verfügbare Textqualität braucht, bekommt sie im eigenen Haus nicht. Der Vorteil liegt woanders, nämlich im Durchsuchen, Zusammenfassen und Vergleichen sensibler Unterlagen ohne Clouddienst dazwischen. Und natürlich der Schutz von IP, Stabilität und Daten und Betriebs-Souveränität.
Dazu eine Korrektur an uns selbst: Wir sind mit der Annahme gestartet, größer sei besser. In Wahrheit schlägt das Modell, das in den vorhandenen Speicher passt und gut Deutsch kann, das theoretisch bessere, das nicht hineinpasst. Und weil ein Modellwechsel eine Konfigurationsänderung ist, ist diese Entscheidung jederzeit umkehrbar.
Die härteren Grenzen sind allerdings keine technischen. Vier Erfahrungen aus dem Eigenbetrieb.
Am Ende steht eine banale Einsicht, die im Alltag trotzdem am meisten Wirkung hat: Das ist ein Werkzeug. Es wird von Menschen beherrscht, nicht umgekehrt. Die Häuser, in denen lokale KI funktioniert, sind nicht die mit der größten Box, sondern die, in denen jemand die Verantwortung dafür übernommen hat, dass die Ergebnisse stimmen.
Ein solcher Stack besteht aus rund 50 Open-Source-Projekten. Jemand muss sie laufend im Blick behalten. Sicherheitsmeldungen treffen unregelmäßig ein, und wer zu lange wartet, schleppt eine bekannte Lücke mit sich herum. Wer selbst betreibt, übernimmt diese Aufgabe. Wer ein fertiges System kauft, gibt sie ab.
Im eingeschwungenen Betrieb rechnen wir im eigenen Haus mit rund vier bis acht Personenstunden pro Monat: Sicherheitsmeldungen sichten, Aktualisierungen einspielen, Nutzerverwaltung, gelegentlich ein Modell tauschen. Dazu kommen 8-16h für ein größeres Release oder eine neue Anbindung. Der Aufwand ist nicht gleichmäßig verteilt — eine kritische Schwachstelle in einer der Komponenten kann einen Tag kosten, und sie kündigt sich nicht an.
Beim Rhythmus unterscheiden wir Komponenten und Modelle. Für den Stack sind mindestens vier Releases pro Jahr zugesagt; tatsächlich liefern wir derzeit monatlich, weil sich das Open-Source-Umfeld schneller bewegt als jeder Release-Kalender. Sicherheitsrelevante Aktualisierungen laufen unabhängig davon, sobald sie vorliegen. Modelle dagegen tauschen wir anlassbezogen, nicht nach Plan: wenn ein neues Modell in unseren eigenen Tests spürbar besser abschneidet, nicht weil es erschienen ist.
Für Umgebungen ohne Internetzugang gibt es das Offline-Update über einen kontrollierten Weg. Das ist kein Randfall — in Produktion, Behörden und kritischer Infrastruktur ist es der Normalfall.
Bei der Governance ändert der lokale Betrieb wenig. Rollen, Zugriffsrechte und Schulungen bleiben Aufgabe des Unternehmens, egal wo das Modell läuft. Bei SEQIS arbeiten nach ISO/IEC 42001 zertifizierte KI-Managementsystem-Auditor:innen; wir begleiten Kunden z.B. beim Aufbau eines eigenen KI-Managementsystems.
„Die Frage, die uns Kunden stellen, ist nie ‚läuft das Modell‘. Sie lautet: Wer darf damit was, und kann ich das im Nachhinein belegen. Dass die KI im eigenen Haus steht, schafft viel Klarheit zur Frage wer was grundsätzlich darf. Zur vollständigen Antwort gehören dann Konzepte zu Rollen & Berechtigungsvergaben, Protokollierung von Änderungen und Abfragen — hier hilft der Stack, aber die Konzeption nimmt einem kein Server ab.“ — Alexander Weichselberger, Managing Partner, SEQIS Group
Wie die Box aufgebaut ist, welche Betriebsarten es gibt und was sie kostet, steht auf der Produktseite zu razzfazz.ai.
Ja — aber die Frage führt an derselben Stelle in die Irre wie bei den Modellen. Open WebUI und Dify sind die bekanntesten Oberflächen. Beide bringen selbst keine Sprachfähigkeit mit, sondern greifen auf ein LLM zu, das Sie separat auswählen. Und beide sind, genau wie viele Modelle, quelloffen, aber nicht Open Source im Sinne der Open Source Initiative: Open WebUI verlangt seit Version 0.6.6, dass die Markenkennung sichtbar bleibt, und nimmt davon nur Installationen mit höchstens 50 Nutzern aus; Dify stellt Apache 2.0 zwei Zusatzbedingungen voran und untersagt unter anderem den Betrieb als Mehrmandanten-Dienst. Für den internen Einsatz im Unternehmen ist beides in aller Regel unproblematisch. Wer die Oberfläche aber unter eigenem Namen ausrollen oder als Dienst für Dritte betreiben will, prüft das besser vorher als nachher.
Die Antwort hängt von der Ebene ab. Bei den Frameworks sind TensorFlow, PyTorch, scikit-learn und MLflow offene Werkzeuge. Bei den Laufzeitumgebungen llama.cpp, vLLM und Ollama. Bei den Modellen erfüllen DeepSeek, Phi, OLMo, Whisper und gpt-oss den OSI-Maßstab vollständig; Mistral und Qwen nur für einen Teil ihrer Modelle. Bei den Oberflächen sind Open WebUI und Dify quelloffen, tragen aber eigene Zusatzbedingungen. Ein Werkzeug der einen Ebene ersetzt keines der anderen.
Bei Apache 2.0 und MIT ja — ohne Beschränkung des Verwendungszwecks, aber nicht ohne Pflichten: Beide verlangen, dass Sie Urheberrechts- und Lizenzhinweise mitführen, Apache 2.0 zusätzlich die NOTICE-Datei und einen Hinweis auf wesentliche Änderungen. Bei Eigenlizenzen wie der Llama 4 Community License, den Gemma-Bedingungen bis Version 3 oder den größeren Qwen-Modellen kommen Auflagen dazu, und manche Anbieter legen neben die Lizenz noch eine Nutzungsrichtlinie, die eigene Grenzen zieht. Prüfen Sie die Lizenz für jedes Modell einzeln, denn eine Familie trägt oft mehrere.
Für Modelle bis 14 Milliarden Parameter reicht bei üblicher Quantisierung — Q4 — eine Maschine mit etwa 8 bis 16 GB Speicher für das Modell. Ab 32 Milliarden Parametern brauchen Sie deutlich mehr, oder Sie weichen auf Systeme mit Unified Memory aus, bei denen sich Prozessor und Grafikeinheit denselben Speicher teilen. Zwei Faktoren kommen in jeder Planung dazu und werden regelmäßig vergessen: Die Kontextlänge belegt eigenen Speicher, der mit ihr wächst — dasselbe Modell mit 8.000 und mit 128.000 Token Kontext sind zwei verschiedene Hardware-Anforderungen. Und die Angaben gelten für einen Nutzer; wer zwanzig Leute gleichzeitig bedienen will, rechnet anders.
Für die Einrichtung ja, für den Betrieb nicht. Ein vollständig abgeschotteter Betrieb ist möglich, die Aktualisierungen holen Sie dann über einen kontrollierten Weg herein. Die Ausnahme sind Funktionen, die bewusst nach draußen greifen — eine Websuche etwa. Ob und wie stark diese nach außen sichtbar wird, ist eine Konfigurationsfrage.
Hier sind zwei Dinge gemeint, und das aufwendigere ist das zweite. Wissen: Das Modell selbst lernt nicht weiter, aktuelles Wissen kommt über die Anbindung an Firmendokumente oder eine kontrollierte Websuche hinein. Neue Modellversionen tauschen Sie gezielt aus, was eine Konfigurationsänderung ist und kein Projekt. Die naheliegende Alternative — das Modell auf die eigenen Daten trainieren — ist teuer, muss bei jeder Änderung wiederholt werden und beantwortet die Frage nach aktuellem Wissen gerade nicht. Software: Der Stack darunter besteht aus vielen Open-Source-Projekten, deren Sicherheitsmeldungen unregelmäßig eintreffen. Dieser Teil kostet die laufende Arbeitszeit.
Die Kostenarten unterscheiden sich grundlegend, und das ist wichtiger als der Betrag. Ein Clouddienst rechnet nach Nutzung ab: Die Kosten starten bei null und steigen mit dem Erfolg — je nützlicher das System wird, desto teurer wird es. Der eigene Betrieb bindet Kapital in Hardware und Arbeitszeit, hat dafür aber eine Obergrenze: Zusätzliche Nutzung kostet nichts extra, ungenutzte Kapazität allerdings auch nichts weniger. In die Vergleichsrechnung gehören auf der lokalen Seite Hardware, Strom und Arbeitszeit für Aktualisierungen und Sicherheitsmeldungen, auf der Cloud-Seite die laufenden Gebühren und der Aufwand für die Prüfung, welche Daten dorthin dürfen. Der Kipppunkt liegt erfahrungsgemäß dort, wo ein Werkzeug von wenigen Interessierten zum Alltagswerkzeug vieler wird — und genau dann ist ein Wechsel am unangenehmsten.
Klären Sie zuerst, über welche der vier Ebenen Sie eigentlich sprechen. Die Lizenz prüfen Sie, bevor der erste Test läuft — und zwar für jedes einzelne Modell, nicht für die Familie. In die Kostenrechnung gehört neben der Hardware die Arbeitszeit für Aktualisierungen und Sicherheitsmeldungen. Und klären Sie zum Schluss, wo Ihre Daten landen. Diese Frage wiegt im Alltag schwerer als die Modellqualität.
Wer Modelle lokal betreiben will, muss nicht bei null anfangen. Der razzfazz.ai Stack bündelt Modell, Oberfläche, RAG, Websuche und den laufenden Betrieb in einem vorkonfigurierten System — für Unternehmen, die KI mit eigenen Daten nutzen wollen, ohne diese an einen externen KI-Dienst zu übertragen.
Stand: 18. September 2026. Rechtliche Angaben geben den Stand zum Zeitpunkt der Veröffentlichung wieder und ersetzen keine Beratung im Einzelfall.
Kommentare (0)
Noch keine Kommentare vorhanden.