Open Source KI | Modelle, Lizenzen & EU AI Act | IT-Dock
Open Source KI ► ✓ Lizenzen von Llama bis Mistral ✓ Pflichten nach EU AI Act ✓ Erfahrungen aus dem lokalen Betrieb
Was ist RAG und wie funktioniert es? So nutzen Unternehmen Retrieval-Augmented Generation für bessere KI-Antworten und produktive RAG-Chatbots.

Große Sprachmodelle haben in kurzer Zeit enorme Aufmerksamkeit gewonnen. Sie beantworten Fragen, fassen Inhalte zusammen und unterstützen Teams in Support, Wissensmanagement und internen Prozessen. In der Praxis zeigt sich aber schnell ein zentrales Problem: Ein Sprachmodell kann sehr überzeugend klingen, auch dann, wenn ihm der aktuelle Unternehmenskontext fehlt.
Genau hier kommt Retrieval-Augmented Generation, kurz RAG, ins Spiel. Der Ansatz verbindet die Sprachfähigkeiten eines LLM mit dem gezielten Abruf relevanter Informationen aus angebundenen Datenquellen. Das können interne Wissensbasen, Dokumentationen, Richtlinien oder auch externe Quellen sein. Das Ergebnis sind Antworten, die nicht nur flüssig formuliert sind, sondern sich deutlich stärker an aktuellen, überprüfbaren Informationen orientieren.
Für C-Level, IT-Leitung und Fachbereiche ist das relevant, denn RAG schlägt die Brücke zwischen generativer KI und produktiv nutzbarem Unternehmenswissen. Statt nur mit statischem Modellwissen zu arbeiten, können Unternehmen ihre Dokumentationen, Wissensdatenbanken, Policies oder Support-Inhalte in die Antwortlogik einbeziehen. Genau dadurch wird aus einem allgemeinen Sprachmodell ein System, das im Unternehmenskontext deutlich nützlicher, kontrollierbarer und wirtschaftlich sinnvoller einsetzbar ist.
Um das Konzept sauber einzuordnen, hilft eine klare Definition. Retrieval-Augmented Generation ist kein einzelnes Tool, sondern ein Verfahren, mit dem ein Sprachmodell vor der Antwort relevante Informationen aus angebundenen Datenquellen abruft und diese als Kontext für die Generierung nutzt.
Einfach gesagt: Das Modell antwortet nicht nur aus seinem vortrainierten Wissen heraus, sondern greift zusätzlich auf passende Inhalte aus einer Wissensbasis zu. Dadurch lassen sich Antworten präziser, aktueller und unternehmensnäher gestalten. Gerade in produktiven Anwendungen ist dieser zusätzliche Kontext entscheidend, da er die Distanz zwischen allgemeinem Modellwissen und konkreter Unternehmensrealität verringert.
Der Begriff setzt sich aus zwei Komponenten zusammen:
Für Unternehmen ist genau diese Kombination entscheidend. Sie macht aus einem allgemeinen Sprachmodell zwar kein allwissendes System, aber ein deutlich besser steuerbares Werkzeug, das interne Informationen, Prozesse und Anwendungen nutzbar machen kann.
Um den Nutzen von RAG zu verstehen, lohnt sich ein Blick auf die Grenzen klassischer Sprachmodelle. LLMs sind leistungsfähig, aber ohne zusätzlichen Unternehmenskontext oft nicht belastbar genug für produktive Anwendungen. Das betrifft vor allem vier Bereiche.
Ein Standard-LLM kennt in der Regel weder Ihre aktuelle Produktdokumentation noch interne Richtlinien, Verträge, Runbooks, Wissensartikel oder Prozessbeschreibungen. Genau dieses Wissen ist in Support, Service, IT-Betrieb und Fachabteilungen jedoch häufig entscheidend. Ohne Zugriff auf diese Inhalte bleiben Antworten oft zu allgemein.
Selbst leistungsfähige Modelle arbeiten mit Trainingsständen, die nicht automatisch jede Änderung in Ihrem Unternehmen oder Markt widerspiegeln. Neue Prozesse, geänderte Preise, aktualisierte Policies, neue technische Dokumentationen oder aktuelle Produktinformationen fehlen dann im Antwortkontext. Für Unternehmen ist das problematisch, denn Aktualität ist in vielen Szenarien keine Kür, sondern Voraussetzung.
Sprachmodelle können plausible, aber falsche Aussagen erzeugen. Im Unternehmenskontext ist das heikel, denn es geht nicht nur um Komfort, sondern um Qualität, Verlässlichkeit, Risiko und teilweise auch Compliance. RAG reduziert dieses Risiko, da Antworten stärker auf konkreten Quellen basieren, kann Halluzinationen aber nicht vollständig ausschließen.
Wenn Antworten nicht auf klaren Quellen beruhen, wird es schwierig, sie intern abzusichern. Für IT-Leitung, Management und Governance ist das ein zentrales Thema. Produktive KI braucht Vertrauen, Kontrollierbarkeit und möglichst nachvollziehbare Antwortgrundlagen. Genau hier bietet RAG klare Vorteile gegenüber rein freier Textgenerierung.
Die Funktionsweise von Retrieval-Augmented Generation lässt sich in mehrere aufeinander aufbauende Schritte unterteilen. Das hilft, den Ansatz nicht nur als Buzzword zu verstehen, sondern als konkrete Systemlogik.
Am Anfang stehen die Inhalte, auf die das System zugreifen soll. Dazu zählen je nach Einsatzszenario zum Beispiel:
Je klarer diese Quellen gepflegt, freigegeben und strukturiert sind, desto besser funktioniert RAG später in der Praxis. Schlechte oder veraltete Inhalte führen auch in einem guten System zu schwachen Ergebnissen.
Die Inhalte werden nicht einfach ungefiltert an ein Sprachmodell übergeben. Stattdessen werden sie in kleinere Sinnabschnitte zerlegt. Dieser Schritt wird häufig als Chunking bezeichnet. Zusätzlich werden die Inhalte mit Metadaten versehen, etwa Quelle, Dokumenttyp, Berechtigungsstufe, Aktualitätsdatum oder Themenbezug.
Anschließend werden die Inhalte für die Suche vorbereitet. Dabei spielen Embeddings eine zentrale Rolle. Texte werden in numerische Vektorrepräsentationen überführt, damit das System semantisch ähnliche Inhalte identifizieren kann. Es sucht also nicht nur nach exakten Begriffen, sondern nach inhaltlicher Nähe. Dieser Schritt ist typischerweise Teil einer Datenpipeline, die Inhalte aufbereitet, versioniert und für den produktiven Betrieb bereitstellt.
Häufig kommt an dieser Stelle eine Vektordatenbank zum Einsatz. Je nach Architektur kann aber auch ein hybrider Suchindex sinnvoll sein, der semantische Suche mit klassischer Keyword-Suche kombiniert.
Stellt ein Nutzer eine Frage oder Anfrage, sucht das RAG-System nach den inhaltlich passenden Textstellen. Anders als eine reine Keyword-Suche identifiziert es semantisch ähnliche Inhalte und versucht, die wahrscheinlich relevantesten Abschnitte zu finden.
Das ist der Kern des Retrieval-Schritts: Aus vielen möglichen Dokumenten oder Chunks werden genau die Inhalte ausgewählt, die zur Anfrage passen. In vielen Architekturen wird zusätzlich ein Re-Ranking eingesetzt, um die Trefferqualität weiter zu verbessern. Dabei werden zuvor gefundene Ergebnisse noch einmal neu priorisiert.
Die gefundenen Inhalte werden dem Sprachmodell als zusätzlicher Kontext bereitgestellt. Statt frei aus dem allgemeinen Modellwissen zu antworten, arbeitet das Modell mit einer konkreteren Informationsbasis. Dieser Schritt ist besonders wichtig, da Sprachmodelle nur eine begrenzte Menge an Kontext gleichzeitig verarbeiten können. Die Auswahl der relevantesten Informationen ist daher entscheidend für die Qualität der späteren Antwort.
Im letzten Schritt formuliert das Sprachmodell eine lesbare, strukturierte Antwort. Im Idealfall basiert sie auf den abgerufenen Inhalten und bleibt dadurch näher an den tatsächlichen Unternehmensinformationen. Die Qualität der Antwort hängt dabei nicht nur vom Modell selbst ab, sondern auch von Datenqualität, Chunking, Retrieval-Logik, Re-Ranking und den verwendeten Guardrails.
Der Begriff RAG-Datenbank wird im Alltag oft als Kurzform für die technische Wissensbasis hinter einem RAG-System verwendet. Gemeint ist damit häufig eine Vektordatenbank oder ein hybrider Suchindex, in dem vorbereitete Inhaltsbausteine gespeichert und für semantische Suche nutzbar gemacht werden.
Wichtig ist aber: Die Datenbank allein ist noch kein RAG. Sie ist nur ein Baustein. Erst das Zusammenspiel aus Datenquellen, Indexierung, Retrieval, Kontextbereitstellung und Sprachmodell ergibt ein vollständiges RAG-System. Wer von einer RAG-Datenbank spricht, meint also meist nicht die gesamte Lösung, sondern die retrieval-nahe Speicher- und Suchschicht.
Ein RAG-System ist die produktive Architektur hinter dem Ansatz. Es besteht nicht nur aus einem LLM, sondern aus mehreren Komponenten, die zusammenarbeiten und im Betrieb aufeinander abgestimmt sein müssen.
Typische Bausteine sind:
Für IT-Leitung und Architekturverantwortliche ist dieser Blickwinkel wichtig, denn er zeigt: RAG ist kein einzelnes Produkt, das man einfach anschaltet. Es ist ein Zusammenspiel aus Daten, Suche, Modell, Governance und Betrieb. Genau deshalb hängt der Erfolg nicht nur am Modell, sondern auch an sauberer Implementierung, Wartung und klaren Verantwortlichkeiten.
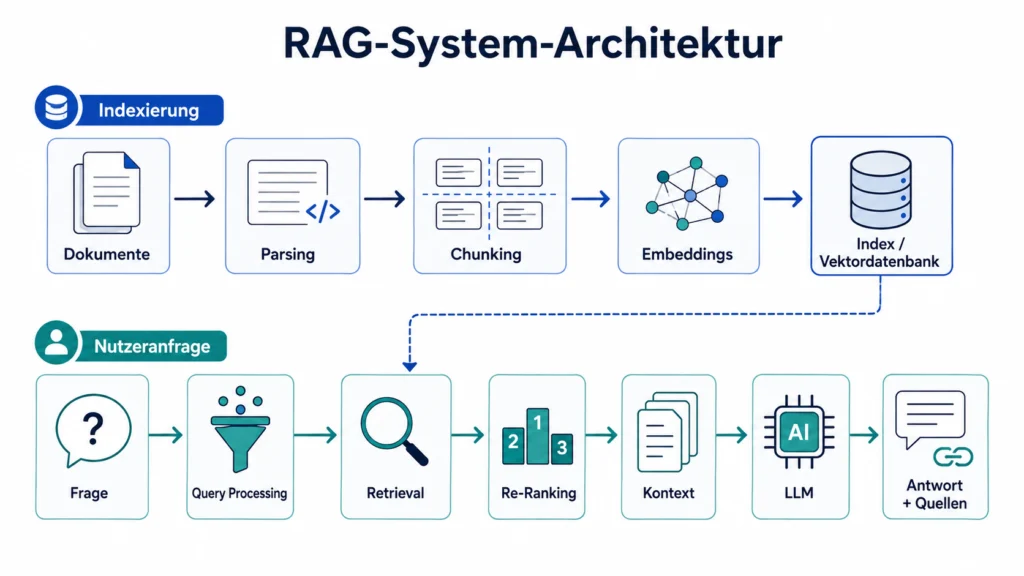
Eine typische RAG-System-Architektur lässt sich vereinfacht als mehrstufiger Ablauf verstehen. Dieser Überblick hilft, die wichtigsten Komponenten in einen Zusammenhang zu bringen.
Zunächst wird relevantes Unternehmenswissen aus den angebundenen Quellen übernommen. Danach werden die Inhalte bereinigt, strukturiert, gechunkt und indexiert. Wird später eine Nutzeranfrage gestellt, interpretiert das System diese Anfrage semantisch und ruft die relevantesten Textstellen ab. Das LLM erzeugt anschließend auf Basis dieses Kontexts die Antwort. Logging, Evaluation, Rechtekonzepte und Monitoring sichern den produktiven Betrieb ab.
Diese Architektur ist deshalb so attraktiv, da sie bestehendes Wissen nutzbar macht, ohne das Modell für jede inhaltliche Änderung neu trainieren zu müssen. Statt ein Modell ständig neu anzupassen, werden Inhalte über die Datenquellen und Suchschicht aktualisiert. Das macht RAG in vielen Unternehmen flexibler und wirtschaftlicher als tiefere Modellanpassungen.
Mit KI erstellt
Nicht jedes RAG-System sieht gleich aus. In der Praxis haben sich mehrere Varianten etabliert, die je nach Datenlage und Anwendungsfall unterschiedlich sinnvoll sein können.
Beim Standard-RAG werden relevante Inhalte aus einer Wissensbasis gesucht und an das LLM übergeben. Das ist der häufigste Einstieg und für viele Unternehmen die praktikabelste Form, um erste produktive Anwendungen aufzubauen.
Beim Hybrid- oder Ensemble-RAG werden mehrere Suchverfahren kombiniert, zum Beispiel semantische Suche und klassische Keyword-Suche. Das verbessert die Trefferqualität häufig dort, wo exakte Begriffe, Produktnamen, Fehlercodes oder spezifische Dokumentstrukturen wichtig sind. Gerade in technischen Wissensbeständen ist das oft ein sinnvoller Ansatz.
Hier werden Beziehungen zwischen Informationen stärker strukturiert modelliert, etwa über Wissensgraphen. Das kann sinnvoll sein, wenn Zusammenhänge zwischen Entitäten, Regeln, Produkten, Rollen oder Prozessen besonders wichtig sind. Solche Ansätze sind meist komplexer, können aber in bestimmten Domänen klare Vorteile bringen.
Advanced RAG erweitert die klassische Retrieval-Pipeline um zusätzliche Optimierungsschritte, damit relevantere Informationen gefunden und bessere Antworten erzeugt werden. Dazu gehören beispielsweise Query Rewriting, Metadatenfilter, Hybrid Search, Re-Ranking oder Context Compression. Ziel ist es, nicht einfach nur ähnliche Textstellen aus einer Datenbank abzurufen, sondern die Suche stärker an der tatsächlichen Nutzerfrage auszurichten. Advanced RAG eignet sich besonders für größere oder heterogene Wissensbestände, bei denen ein einfacher semantischer Suchlauf nicht zuverlässig genug ist.
Bei Agentic RAG übernimmt ein KI-Agent die Steuerung des Retrieval-Prozesses. Statt immer nach demselben festen Ablauf zu arbeiten, kann der Agent abhängig von der Anfrage entscheiden, welche Datenquelle durchsucht, welches Tool genutzt oder ob eine weitere Suche notwendig ist. Komplexe Fragen können so in mehrere Teilaufgaben zerlegt und Informationen aus verschiedenen Systemen zusammengeführt werden. Agentic RAG ist vor allem dann interessant, wenn Unternehmenswissen über mehrere Quellen verteilt ist oder eine Anfrage nicht mit einem einzelnen Retrieval-Schritt beantwortet werden kann.
Multimodales RAG erweitert das klassische textbasierte Retrieval um weitere Datenformate. Ein System kann dadurch neben Text beispielsweise auch Bilder, Tabellen, Diagramme, Präsentationen oder andere visuelle Informationen durchsuchen und in die Antwort einbeziehen. Das ist besonders relevant bei technischen Dokumentationen, Produktunterlagen oder Reports, bei denen wichtige Informationen nicht ausschließlich im Fließtext stehen. Voraussetzung ist, dass die unterschiedlichen Inhalte zuverlässig extrahiert, indexiert und für das verwendete Modell verständlich aufbereitet werden.
RAG, Fine-Tuning und Long Context lösen unterschiedliche Probleme und sind deshalb keine direkten Alternativen in jedem Anwendungsfall. RAG eignet sich vor allem dann, wenn ein Sprachmodell auf aktuelle oder umfangreiche Unternehmensinformationen zugreifen soll. Die benötigten Inhalte werden erst bei einer Anfrage gesucht und dem Modell als zusätzlicher Kontext bereitgestellt. Fine-Tuning verändert dagegen das Modell selbst: Es wird mit zusätzlichen Beispielen trainiert, um beispielsweise ein bestimmtes Verhalten, einen Stil oder eine spezialisierte Aufgabe besser zu beherrschen. Für die laufende Aktualisierung von Unternehmenswissen ist Fine-Tuning daher meist weniger geeignet.
Bei Long Context werden relevante Dokumente oder Informationen direkt in das große Kontextfenster eines Sprachmodells gegeben, ohne zuvor eine klassische Retrieval-Pipeline aufzubauen. Das kann bei einer überschaubaren Zahl von Dokumenten oder einzelnen umfangreichen Analysen sinnvoll sein. Je größer und dynamischer der Wissensbestand wird, desto wichtiger werden jedoch Faktoren wie Kontextgröße, Kosten, Latenz und die gezielte Auswahl relevanter Informationen. In der Praxis können die Ansätze auch kombiniert werden: Ein fein abgestimmtes Modell kann beispielsweise innerhalb eines RAG-Systems eingesetzt werden, während große Kontextfenster genutzt werden, um mehrere gefundene Dokumente gemeinsam auszuwerten.
| Kriterium | RAG | Fine-Tuning | Long Context |
|---|---|---|---|
| Hauptzweck | Externes Wissen gezielt bereitstellen | Verhalten und Fähigkeiten des Modells anpassen | Viele Informationen direkt im Kontext verarbeiten |
| Aktuelle Informationen | Sehr gut geeignet | Nur durch erneutes Training | Gut geeignet |
| Große Wissensbestände | Sehr gut skalierbar | Nicht als Wissensspeicher gedacht | Durch Kontextfenster begrenzt |
| Häufig wechselnde Daten | Einfach aktualisierbar | Vergleichsweise aufwendig | Einfach austauschbar |
| Unternehmenswissen | Sehr gut geeignet | Nur bedingt sinnvoll | Gut bei überschaubaren Datenmengen |
| Quellenangaben | Gut umsetzbar | Nur schwer | Möglich |
| Modellverhalten verändern | Nein | Ja | Nein |
| Zusätzliche Infrastruktur | Retrieval, Index und ggf. Vektordatenbank | Trainingspipeline und Rechenleistung | Vergleichsweise gering |
| Latenz und Kosten | Abhängig von Retrieval und Pipeline | Im Betrieb meist unabhängig vom Training | Können bei sehr großen Kontexten steigen |
| Typischer Einsatz | Wissensassistenten, RAG-Chatbots, Enterprise Search | Fachspezifisches Verhalten, Stil, Klassifikation | Dokumentenanalyse, einzelne große Informationsmengen |
RAG kann die Qualität und Aktualität von KI-Antworten deutlich verbessern, löst aber nicht automatisch alle Probleme großer Sprachmodelle. Entscheidend ist vor allem die Qualität des Retrievals: Findet das System falsche oder unvollständige Informationen, kann auch das Sprachmodell keine verlässliche Antwort daraus erzeugen. Schlecht gewählte Chunks können wichtige Zusammenhänge auseinanderreißen, während eine rein semantische Ähnlichkeit nicht immer bedeutet, dass ein Treffer fachlich wirklich relevant ist. Auch Halluzinationen lassen sich mit RAG reduzieren, aber nicht vollständig verhindern. Hinzu kommen zusätzlicher Architektur- und Betriebsaufwand sowie mögliche Auswirkungen auf Latenz und Kosten durch Retrieval, Re-Ranking und weitere Verarbeitungsschritte. Je größer das System wird, desto wichtiger werden deshalb kontinuierliche Evaluation, gepflegte Datenquellen und eine gezielte Optimierung der gesamten RAG-Pipeline.
Ein RAG-Chatbot ist eine Anwendung, die ein RAG-System über eine Chat-Oberfläche nutzbar macht. Mitarbeitende oder Kunden können Fragen in natürlicher Sprache stellen, während das System im Hintergrund relevante Inhalte abruft und in die Antwort einbezieht.
Im Gegensatz zu herkömmlichen Chatbots wird nicht nur allgemeines Modellwissen genutzt. Bei Anfragen greift das System aktiv auf relevante Unternehmensinhalte zu. Dadurch wird ein RAG-Chatbot deutlich nützlicher für produktive Szenarien. Statt generische Antworten zu liefern, kann er auf Dokumentation, interne Wissensartikel, Richtlinien oder verifizierte Prozessinformationen zurückgreifen.
Ein RAG-Chatbot ist besonders sinnvoll, wenn viele wiederkehrende Anfragen beantwortet werden müssen, Wissen über verschiedene Systeme verteilt ist, Aktualität und Quellenbezug wichtig sind oder Support- und Suchaufwand reduziert werden sollen. Genau deshalb ist der RAG-Chatbot für viele Unternehmen einer der naheliegendsten Einstiege in produktive generative KI.
RAG entfaltet seinen Wert vor allem dort, wo Wissen schnell, präzise und nachvollziehbar verfügbar sein muss. Das macht den Ansatz für verschiedene Anwendungen im Unternehmen interessant.
Im IT-Support und Service Desk können Mitarbeitende oder Kunden Antworten auf Basis von Runbooks, Known Issues, Knowledge Base oder Produktdokumentationen erhalten. Im internen Wissensmanagement wird verteiltes Wissen aus Wikis, Richtlinien, Prozessdokumenten oder internen FAQs zentral nutzbar. In der Richtlinien- und Compliance-Suche finden Mitarbeitende schneller relevante Vorgaben, ohne lange in Dokumentenlandschaften suchen zu müssen.
Auch in der Produkt- und Projektdokumentation ist RAG nützlich. Technische Informationen, Spezifikationen oder Projekthintergründe werden kontextbezogen abrufbar. Darüber hinaus profitieren Fachabteilungen wie HR, Sales, Legal oder Einkauf von einer präzisen, quellenbasierten Wissensassistenz. Die konkreten Anwendungen hängen immer vom Datenbestand und vom betrieblichen Ziel ab, das Grundprinzip bleibt jedoch gleich: Verstreutes Wissen wird schneller und gezielter nutzbar.
Die folgende Tabelle gibt eine gute Übersicht über die jeweiligen Bereiche, Anwendungen und die jeweiligen Datenquellen.
| Bereich | Anwendung | Typische Datenquellen |
|---|---|---|
| IT-Support | Support-Assistent | Tickets, Runbooks, Knowledge Base |
| Kundenservice | RAG-Chatbot | FAQ, Produktdokumentation |
| Wissensmanagement | interne KI-Suche | Wiki, SharePoint, Dokumente |
| Vertrieb | Sales-Assistent | Produktinfos, Cases, Angebote |
| HR | Mitarbeiter-Assistent | Richtlinien, Benefits, Prozesse |
| Legal | Dokumentenrecherche | Verträge, Richtlinien |
| Compliance | Regelwerksuche | Policies, Normen |
| Technik | Dokumentationsassistent | Handbücher, Spezifikationen |
Technik allein reicht für produktives RAG nicht aus. Entscheidend ist auch, wie Inhalte gepflegt, abgesichert, freigegeben und überwacht werden. Genau hier trennt sich ein Demo-System von einem belastbaren produktiven Betrieb.
Wichtige Themen sind Datenqualität, denn schlechte oder veraltete Inhalte erzeugen schlechte Antworten. Ebenso zentral sind Berechtigungen, da nicht jeder Nutzer jede Information sehen darf. Datenschutz spielt eine wichtige Rolle, wenn sensible Inhalte verarbeitet oder angezeigt werden. Wer maximale Datenkontrolle will, kann auch das Sprachmodell selbst im eigenen Netz betreiben – etwa mit DeepSeek lokal. Hinzu kommen Freigabeprozesse, die klären, welche Inhalte verlässlich und freigegeben sind.
Ebenso relevant ist die Auditierbarkeit: Wie lässt sich nachvollziehen, worauf eine Antwort basiert? Dazu kommen Monitoring und Evaluation. Unternehmen müssen verstehen, wie gut das Retrieval funktioniert, wo Fehler entstehen und wie Antwortqualität sowie Nutzwert gemessen werden. Für IT-Leitung ist das keine Nebensache, sondern Kern der Einführungsstrategie.
Bei produktiven RAG-Systemen müssen nicht nur das Sprachmodell, sondern auch Wissensquellen, Suchindex und Retrieval-Prozess abgesichert werden. Ein wichtiges Risiko ist die sogenannte indirekte Prompt Injection: Enthält ein eingebundenes Dokument manipulierte Anweisungen, können diese beim Retrieval in den Kontext des Sprachmodells gelangen und dessen Verhalten beeinflussen. Ebenso kritisch ist Data Leakage, wenn Nutzer über das RAG-System Informationen aus Dokumenten erhalten, für die sie eigentlich keine Berechtigung besitzen. Auch manipulierte oder fehlerhafte Inhalte in der Wissensbasis können Antworten systematisch verfälschen. Unternehmen sollten deshalb Zugriffsrechte möglichst bis auf Dokument- oder Inhaltsebene berücksichtigen, neue Datenquellen kontrollieren und neben den eigentlichen Dokumenten auch Vektordatenbanken, Logs, Chatverläufe und angebundene Schnittstellen in ihr Sicherheitskonzept einbeziehen.
Die Qualität eines RAG-Systems sollte auf zwei Ebenen bewertet werden: beim Retrieval und bei der erzeugten Antwort. Beim Retrieval geht es darum, ob das System tatsächlich die relevanten Dokumente und Textstellen findet und wichtige Informationen nicht übersieht. Dafür können technische Kennzahlen wie Precision@K, Recall@K oder Hit Rate genutzt werden. Bei der Antwortqualität ist entscheidend, ob die Antwort fachlich korrekt ist, die Nutzerfrage tatsächlich beantwortet und durch die gefundenen Quellen gestützt wird. Zusätzlich können Unternehmen beispielsweise messen, wie häufig falsche oder unvollständige Antworten auftreten, wie oft Nutzer nachfragen müssen oder wie häufig eine menschliche Korrektur notwendig ist. Sinnvoll ist deshalb eine Kombination aus technischen Metriken, regelmäßigen Testfragen und Feedback aus der tatsächlichen Nutzung.
Ein RAG-System benötigt bei jeder Anfrage zusätzliche Verarbeitungsschritte, die über einen normalen LLM-Aufruf hinausgehen. Kosten und Latenz entstehen unter anderem durch die Suche im Index, die Erzeugung von Embeddings, Re-Ranking und die Verarbeitung der gefundenen Inhalte durch das Sprachmodell. Je mehr Dokumente durchsucht, Treffer bewertet und Textpassagen in den Kontext übernommen werden, desto höher können Rechenaufwand, Tokenverbrauch und Antwortzeit ausfallen. Auch zusätzliche Schritte wie Query Rewriting oder mehrere Retrieval-Durchläufe bei Advanced oder Agentic RAG erhöhen den Aufwand. Entscheidend ist deshalb nicht, möglichst viele Informationen in die Pipeline aufzunehmen, sondern die relevantesten Inhalte effizient zu finden. Gute RAG-Architekturen müssen immer zwischen Antwortqualität, Geschwindigkeit und Kosten abwägen.
Der größte Fehler in RAG-Projekten ist oft, zu breit zu starten. Erfolgreiche Implementierungen beginnen meist mit einem klar eingegrenzten Use Case, überschaubaren Datenquellen und definierten Erfolgskriterien. Gerne können Sie sich hierzu auch von Boston IT, einem Unternehmen mit tiefem Fachwissen in Sachen RAG, beraten lassen.
Ein sinnvoller Weg sieht so aus:
Zum Beispiel Kundensupport, interne IT-Hilfe oder Wissenssuche in Richtlinien.
Welche Inhalte sollen wirklich eingebunden werden? Welche sind aktuell, gepflegt und relevant?
Vor Projektstart sollte klar sein, woran Erfolg gemessen wird. Denkbar sind kürzere Bearbeitungszeiten, geringerer manueller Suchaufwand, bessere Erstlösungsquoten, höhere Servicequalität oder geringere Ticketlast.
Ein überschaubarer Scope reduziert Risiko und schafft belastbare Lernkurven.
Erst wenn Datenqualität, Governance, Sicherheit und Nutzwert stimmen, sollte skaliert werden.
Gerade für Unternehmen mit hohem Support- oder Wissensdruck ist ein PoC oft der pragmatischste Startpunkt.
RAG ist nicht für jede Fragestellung automatisch die beste Lösung. Der Ansatz lohnt sich besonders dann, wenn mehrere typische Bedingungen zusammenkommen.
RAG ist vor allem interessant, wenn Wissen verteilt in vielen Quellen vorliegt, Mitarbeitende viel Zeit mit Suchen verbringen, Antworten auf aktuellen Informationen basieren müssen, Nachvollziehbarkeit und Datenhoheit wichtig sind oder Support und Fachbereiche entlastet werden sollen. Auch wenn ein Chatbot oder Assistent produktiv nutzbar werden soll, ist RAG oft ein sinnvoller Weg.
Je größer die Wissensfragmentierung und je höher der Bedarf an verlässlichen Antworten, desto attraktiver wird RAG. Unternehmen sollten den Ansatz also nicht als Selbstzweck verstehen, sondern als Architekturentscheidung für konkrete Probleme rund um Wissen, Zugriff und Antwortqualität.
Retrieval-Augmented Generation ist weit mehr als ein technischer Trendbegriff. Für Unternehmen ist RAG ein praktikabler Weg, generative KI mit dem eigenen Wissen zu verbinden und dadurch verlässlichere, aktuellere und besser nachvollziehbare Antworten zu erzeugen.
Gerade für C-Level, IT-Leitung und Fachbereiche ist das entscheidend. Denn die Frage lautet nicht mehr, ob generative KI Potenzial hat, sondern wie sie kontrolliert, sinnvoll und wirtschaftlich in reale Prozesse integriert werden kann. RAG ist dafür oft ein sehr guter Einstieg: verständlich im Konzept, stark im Business-Nutzen und anschlussfähig an produktive Anwendungen wie Support, Wissensmanagement und interne Assistenzsysteme. Hierbei sind Ihnen die Experten von Boston IT gerne behilflich.
RAG ist ein Verfahren, bei dem ein Sprachmodell vor der Antwort relevante Informationen aus angebundenen Datenquellen abruft und diese als Kontext nutzt.
RAG verbindet Datenquellen, Suchlogik und ein Sprachmodell. Relevante Inhalte werden gesucht, als Kontext bereitgestellt und anschließend vom Modell in eine Antwort überführt.
Ein RAG-System ist die produktive Kombination aus Wissensquellen, Datenpipeline, Indexierung, Retrieval, Sprachmodell, Zugriffskontrollen und Monitoring.
Ein RAG-Chatbot beantwortet Fragen auf Basis aktueller, relevanter Unternehmensinformationen statt nur mit allgemeinem Modellwissen.
Nicht zwingend in jedem Aufbau, aber in vielen modernen RAG-Architekturen ist eine Vektordatenbank ein zentraler Baustein für semantische Suche.
RAG erweitert ein Modell um aktuelles, quellenbasiertes Wissen. Fine-Tuning verändert eher Verhalten, Stil oder Ausgabeformat des Modells.
„Augmented“ bezeichnet den Schritt, bei dem die durch das Retrieval gefundenen Informationen dem Kontext des Sprachmodells hinzugefügt werden. Das Modell beantwortet die Nutzerfrage dadurch nicht nur auf Basis seines trainierten Wissens, sondern erhält zusätzlich passende Informationen aus den angebundenen Datenquellen.
RAG kann Halluzinationen reduzieren, aber nicht vollständig verhindern. Findet das Retrieval falsche, unvollständige oder irrelevante Informationen, kann auch das Sprachmodell daraus eine fehlerhafte Antwort erzeugen. Neben hochwertigen Datenquellen sind deshalb gutes Retrieval, Re-Ranking, geeignete Prompts und eine kontinuierliche Evaluation wichtig.
Bei RAG werden zunächst gezielt relevante Informationen aus einem größeren Wissensbestand gesucht und anschließend an das Sprachmodell übergeben. Bei Long Context werden dagegen größere Dokumente oder Informationsmengen direkt in das Kontextfenster des Modells geladen. Long Context kann bei überschaubaren Datenmengen sinnvoll sein, während RAG insbesondere bei großen, verteilten oder häufig aktualisierten Wissensbeständen Vorteile bietet.
Grundsätzlich können sehr unterschiedliche strukturierte und unstrukturierte Datenquellen eingebunden werden. Dazu gehören beispielsweise PDFs, Produktdokumentationen, Wikis, SharePoint-Inhalte, Wissensdatenbanken, Support-Tickets, Richtlinien, Datenbanken oder interne Fachanwendungen. Entscheidend ist, dass die Inhalte technisch zugänglich, ausreichend aktuell und für den jeweiligen Anwendungsfall freigegeben sind.
Kommentare (0)
Noch keine Kommentare vorhanden.